DevOps & SRE

Viele Plattformen stehen bereit und werden kaum genutzt. Die Landing Zone läuft, das Pipeline-Template existiert. Trotzdem deployen die Teams noch wie vor drei Jahren, weil sie den alten Weg kennen.

Wir arbeiten innerhalb Ihrer Teams, bis die Plattform der Weg des geringsten Widerstands ist, und wir halten das, was darauf läuft, schnell und reibungslos, sobald es soweit ist.

VERTRAUT VON ENGINEERING-TEAMS BEI:

  • Deutsche Telekom Logo: weißer stilisierter Buchstabe T auf einem Magenta-Hintergrund
  • Uniper-Logo in Blau, das Wort „uniper" auf zwei Zeilen aufgeteilt.
  • GOLDBECK-Logo in fetten schwarzen Großbuchstaben auf weißem Hintergrund
  • PwC-Logo mit den Kleinbuchstaben „pwc" in Schwarz und zwei orangefarbenen diagonalen Formen darüber
  • Vattenfall-Logo mit dem Namen in dunkelgrauen fetten Buchstaben und einem Kreis, der in eine gelbe obere Hälfte und eine blaue untere Hälfte geteilt ist, auf der rechten Seite
  • Schwarz-produktion-Logo auf weißem Hintergrund mit dem Schriftzug „SCHWARZ PRODUKTION" in weißer Schrift in einem dunkelblauem Quadrat.
  • Cornelsen Logo — weißes, fettes Wortmarke auf rotem Hintergrund
  • Meridiam-Logo mit dem Slogan „for people and the planet" in Dunkelgrün auf weißem Hintergrund.

Was genau ist DevOps & SRE?

Platform Engineering legt das Fundament. DevOps und SRE sorgen dafür, dass Ihre Teams davon profitieren. Wir bieten beide Disziplinen an. Fehlt eine davon, haben Sie entweder eine Plattform, die niemand nutzt, oder Teams, die auf einem wackligen Fundament optimieren.

Hier geht es um alles, was auf dem Fundament aufbaut. Fehlt Ihnen das Fundament selbst, bauen wir es im Rahmen von Platform Engineering. Oder Sie wählen KumoOps und sparen sich den Aufbau ganz. Wir arbeiten direkt in Ihren Teams, an Ihren Services und gemeinsam mit Ihren Leuten. So gelingt Enablement.


Nicht sicher, was Sie benötigen?

  1. Platform EngineeringNoch keine Plattform und Sie möchten eine aufbauen.
  2. KumoOpsEine Plattform ohne selbst eine zu bauen.
  3. DevOps & SREDie Plattform existiert und Ihre Teams nutzen sie nicht. Sie sind hier richtig.

Golden Paths, keine Dokumentation

Ein Team nimmt eine Plattform an, wenn das Deployment darauf schneller ist als die Alternative. Wir bauen ein Template pro Framework, das Sie tatsächlich einsetzen – mit Pipeline, Helm-Chart, Base-Image, Policies und Dashboards, die bereits verdrahtet sind. Ein neuer Service geht am ersten Tag in Produktion statt in der sechsten Woche. Die angestrebte Abdeckung umfasst die wenigen Service-Typen, die den Großteil dessen ausmachen, was Sie entwickeln.
Mehrere Personen sitzen an einem langen Holztisch in einem holzvertäfelten Raum und nehmen an einem Workshop teil, mit Laptops und Getränken auf dem Tisch.

Pipelines und Packaging, neu aufgebaut für das, was Sie heute liefern

KI hat das Schreiben von Code beschleunigt. Build, Test und Release laufen oft so langsam wie vorher. Genau dort staut sich jetzt der zusätzliche Output. Wir modernisieren Pipelines und containerisieren Anwendungen, die nie dafür ausgelegt waren. Außerdem bringen wir das Packaging in Ordnung: Base-Images mit klarer Verantwortung, eine SBOM pro Build, signierte Artefakte und Promotion zwischen Stages ohne Neubau des Images. Schnellere Releases und eine Supply Chain, die ein Prüfer nachvollziehen kann, gehen dabei Hand in Hand.

Zwei Kollegen sitzen an einem Holztisch, jeder konzentriert auf seinen eigenen Laptop.

Zuverlässigkeit messbar machen, nicht nur behaupten

Die meisten SLOs scheitern, weil sie den Load Balancer statt des Nutzers messen, oder p50 statt p99. Wir definieren Ziele aus echten User Journeys, instrumentieren die Services entsprechend mit OpenTelemetry und reduzieren Alerting auf das, wofür jemand tatsächlich geweckt werden sollte. Wenn doch etwas ausfällt, lautet das Ziel jedes Mal gleich: Ursache in Minuten finden, nicht in einem War Room mit vierzehn Leuten im Call.

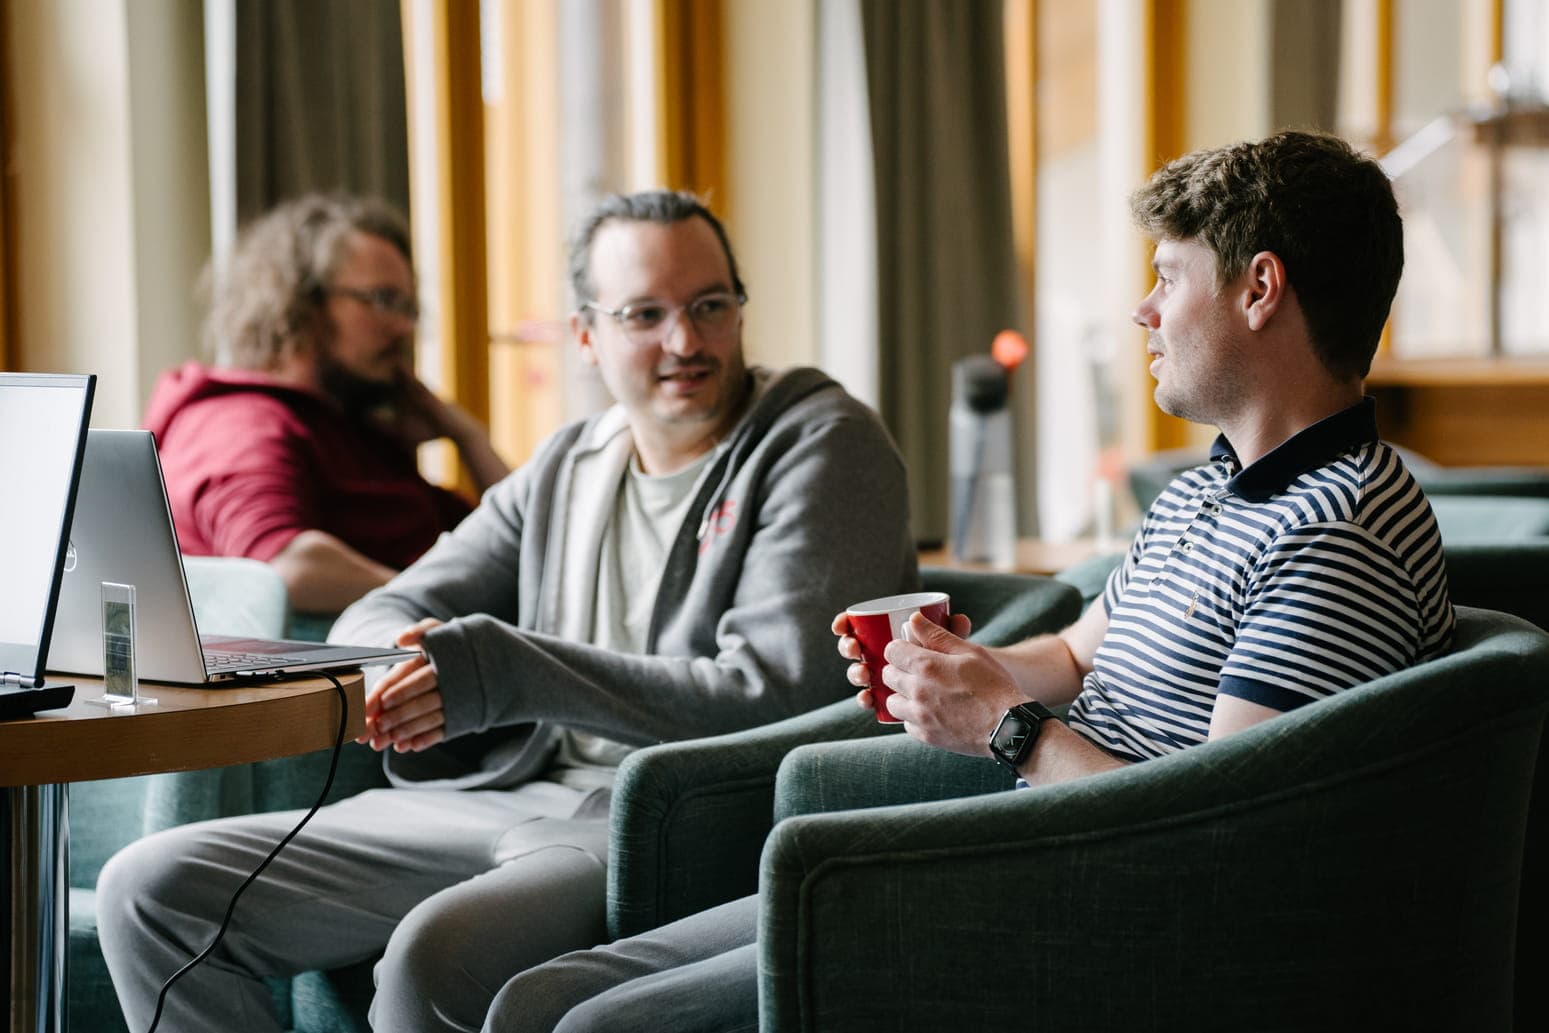
Drei Personen sitzen auf grünen Sesseln in einem hellen Loungebereich und unterhalten sich neben einem Laptop und einem kleinen Tisch.

Warum das verändert, was Ihre Teams liefern können

  • Enablement mit einem EnddatumWir arbeiten gemeinsam mit Ihren Engineers an ihren Services, anstatt ein Wiki zu übergeben. Der Maßstab für Erfolg ist, dass Sie uns beim nächsten Mal nicht mehr anrufen.
  • Golden Paths aus einer getesteten Bibliothek55 Terraform-Module und 40 Helm-Charts, bereits andernorts in Produktion. Ihre Templates starten von bewährten Bausteinen, nicht von einer leeren Datei.
  • Wir verbessern die Kennzahlen, an denen Sie gemessen werdenDeployment-Häufigkeit, Lead Time for Changes, Change Failure Rate und Recovery Time: Wir messen sie vor dem Start und erneut bei der Übergabe. Dazu kommen SLOs pro Service und ein Toil-Inventar. So werden Verbesserungen sichtbar und belegbar.
  • Regulierte Umgebungen sind der NormalfallKRITIS, Gesundheitswesen, Carrier, Finanzdienstleistungen. Policies, Nachweise und Aufgabentrennung bleiben erhalten, während die Liefergeschwindigkeit steigt. Der Grund: Sie sind fester Teil der Pipeline.
  • Sie entscheiden, wer danach den Pager trägtIhre Teams übernehmen On-Call mit den Runbooks und Dashboards, die wir gemeinsam mit ihnen erstellt haben. Oder KumoOps übernimmt – unsere fertige Cloud-Plattform inklusive CloudOps, zum monatlichen Festpreis mit Incident Response unter 15 Minuten.

Vier Schritte. Von der Bestandsaufnahme zum Regelbetrieb.

  1. Schritt 01

    Messen, was Sie haben

    Die vier Delivery-Metriken, ein Toil-Inventar und ein Value Stream, der von Commit bis Produktion vollständig abgebildet ist. Meist ist der langsamste Schritt nicht dort, wo ihn jemand vermutet.

  2. Schritt 02

    Einen Golden Path aufbauen

    Der Service-Typ, den Sie am häufigsten erstellen, vollständig: Pipeline, Packaging, Policies, Observability, Rollback. Ein echtes Team, ein echter Service, in Produktion.

  3. Schritt 03

    Rollout durch Pairing.

    Die nächsten Teams migrieren mit uns an ihrer Seite, nicht anhand eines Handbuchs. Jede Migration verbessert das Template und verkürzt die nächste.

  4. Schritt 04

    Den Zuverlässigkeitskreislauf schließen

    SLOs, Error Budgets, On-Call-Rotation und Blameless Postmortems mit echter Wirkung. Danach betreibt Ihr Team die Plattform, oder KumoOps übernimmt.

Branchen, in denen wir unterstützen

Telekommunikation

Carrier-Grade-Delivery, bei der ein fehlgeschlagenes Rollout innerhalb von Minuten für Millionen sichtbar wird.

Financial Services

Change Control und Aufgabentrennung direkt in der Pipeline, als automatisierter Teil jedes Releases.

Logistik & E-Commerce

Saisonale Zuverlässigkeit mit SLOs, die an den Bestellfluss gebunden sind, und nicht an die Server-Uptime.

Healthcare

Regulierte Release-Pfade mit vollständiger Nachverfolgbarkeit vom Commit bis zur deployten Version.

Die Zusammenarbeit mit dem Team ist aus Kundenperspektive wirklich angenehm. Anforderungen werden durchdacht hinterfragt, um die höchste Qualität der Softwareprodukte sicherzustellen. Die Teams sind Meister ihres Fachs und gewährleisten den reibungslosen Betrieb der containerisierten Cloud‑Anwendung.
Uniper-Logo in Weiß auf blauem HintergrundLars DonatUniper Energy Sales · Uniper SE

Womit wir arbeiten.

Nichts davon ist exotisch, und das ist Absicht. Ihre Teams sollen alles nach unserem Einsatz selbst betreiben können. Passende Fachkräfte dafür sollten leicht zu finden sein. Deshalb setzen wir auf Tools mit großen Ökosystemen und guter Dokumentation. Unsere Energie steckt in der sinnvollen Verknüpfung dieser Tools.

DELIVERY
  • GitLab CI
  • Argo CD
  • Progressive Rollouts
  • Automatisiertes Rollback
  • Trunk based Delivery
PACKAGING & RUNTIME
  • Helm
  • Kustomize
  • Kubernetes
  • Container Images
  • Base Images
  • Signierte Artefakte
RELIABILITY
  • SLOs aus User Journeys
  • OpenTelemetry
  • Grafana
  • On-Call-Design
  • Fehlerbudgets
  • Schuldfreie Postmortems

Ihre Plattform läuft. Wie viele Teams sind aktuell darauf?

Zwei Wochen, ein Value Stream, Ihre vier Delivery-Metriken und die Liste der Hindernisse. Unverbindlich.

DURCHSCHN. ANTWORTZEIT < 1 WERKTAG